从一个家庭药柜到公网 AI 问诊:AI token 深解析与宝塔部署全流程实录
项目地址:zyf.seguzhixue.cn(家庭中药柜索引 + AI 倪师问诊,Flask + SQLite + 原生 JS,单容器 Docker 部署)。这篇文章把从「一张截图里的药柜表」到「公网可访问的 AI 问诊站」全过程里,值得复用的关键动作沉淀下来——AI 上下文里每一类 token 从哪来、怎么算、怎么裁、参数怎么配,55 张图怎么不花一分钱跑通,宝塔 Docker 从零到 https 的每一步、反向代理哪里最容易踩坑,以及更新与回滚的完整闭环。
一、项目长什么样
两个标签页,全部功能围绕「家里真实的药柜」:
药柜索引——187 味药材按七个柜层(望岳 / 含章 / 厚德 / 知味 / 藏珍 / 承露 / 拾遗)登记,每味带实拍图、性味归经、功效、位置、注意事项;另含食补食材、18 首经方、55 首自制调养方、安全协议。
AI 倪师问诊——四个内置技能(症状辨析 / 配方建议 / 经方与专栏方速查 / 药材知识),把整柜药材清单压进 system prompt,问「昨晚淋雨受凉鼻塞怕风」它回答用的每味药都标着「第 X 层」。
技术栈刻意保守:Flask 3 + SQLite + 无构建步骤的原生 JS,一个 252KB 的数据库文件 + 62MB 图片目录就是全部状态,Docker 单容器可跑。选这套不是为了怀旧,而是家庭工具的第一需求是十年后还能跑。
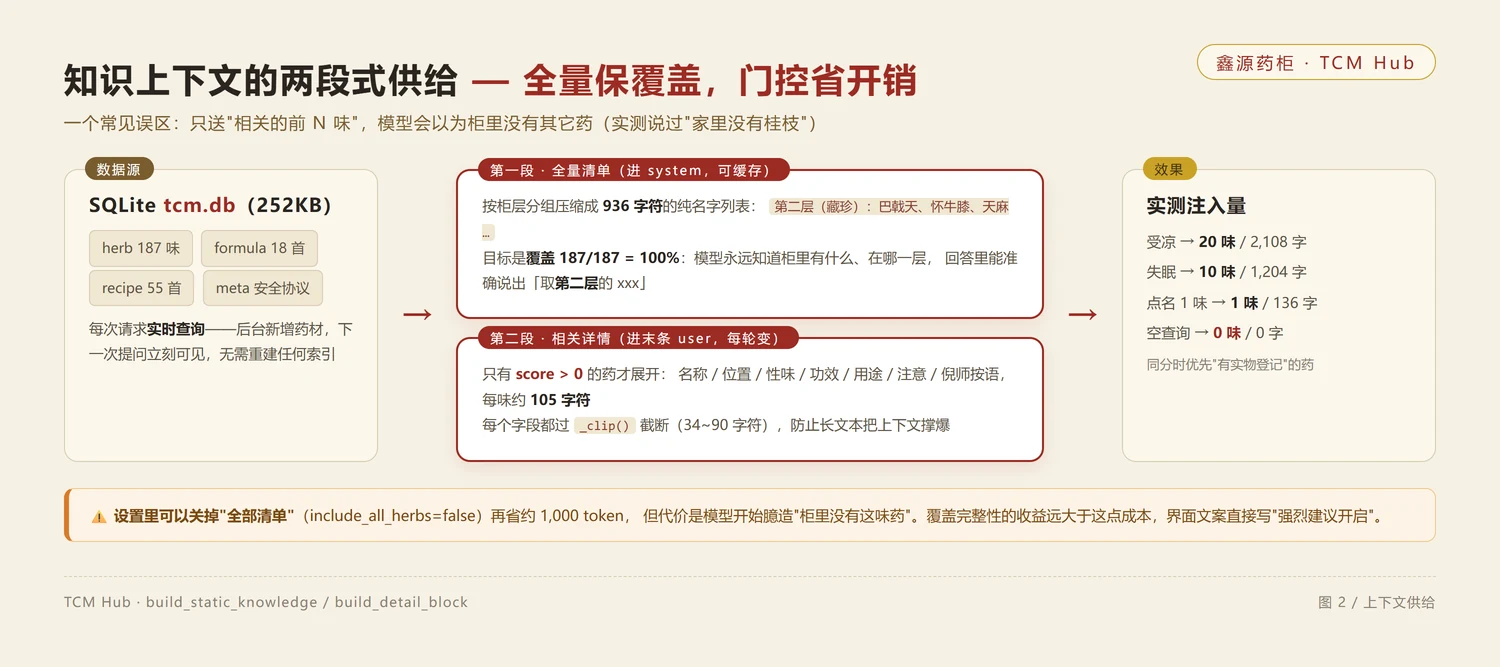
支撑 AI 问诊的知识供给是两级结构:全量清单常驻 system 前缀(便宜、稳定、可缓存),重量级详情按需注入(贵、易变、必须门控):
二、AI token 深解析:从计算方式到省钱配置
这一章把 AI 问诊的 token 账本彻底摊开:每一类 token 从哪来、怎么统计、怎么裁剪、参数怎么配、省了多少、代价是什么。所有数字都来自项目里的实测脚本 verify_ai_context.py 和真实 API 响应,不是估算。
2.1 token 是怎么算的:usage 字段透传成「账单行」
DeepSeek 的 OpenAI 兼容接口在每次响应里都带 usage 对象。后端原样透传给前端:
res = call_api(ai_cfg, messages)
return {"content": res["content"], "usage": res.get("usage"),
        "context_chars": ..., "detail_count": ...}
前端在每条回复气泡下方渲染一行用量小字:
// templates/index.html
const u = m.usage && (m.usage.prompt_tokens || m.usage.total_tokens);
if(u) bits.push(`输入 <b>${m.usage.prompt_tokens||0}</b> / 输出 <b>${m.usage.completion_tokens||0}</b> tokens · 缓存命中 <b>${m.usage.prompt_cache_hit_tokens}</b>`);
这行小字就是「账单」:
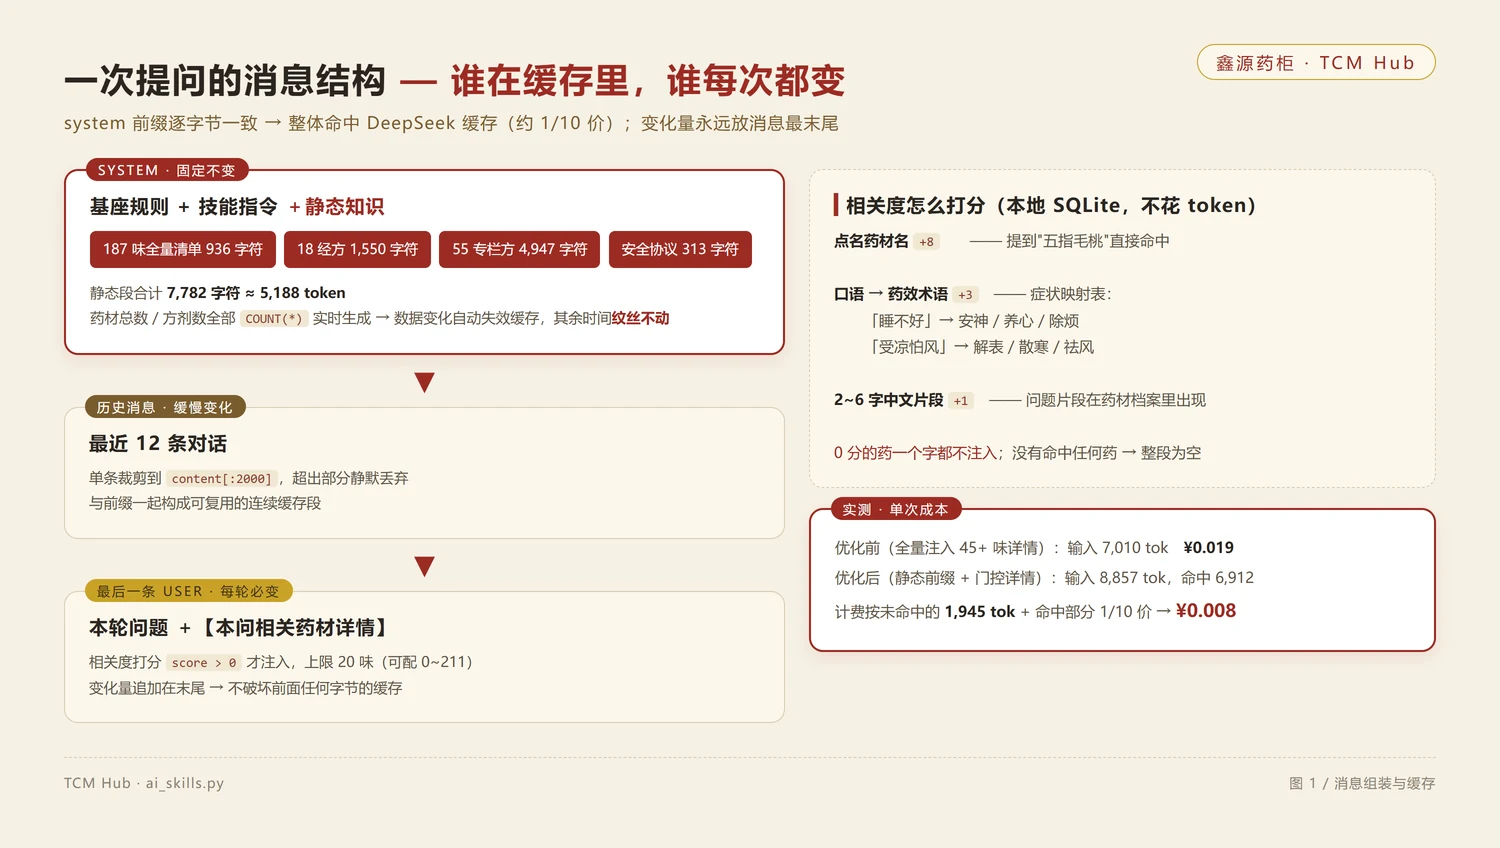
prompt_tokens——本次输入总量(system + 全部历史 + 本轮提问 + 动态详情块);completion_tokens——本次输出总量(推理模型的思考部分也算在这里);prompt_cache_hit_tokens——输入中命中前缀缓存、按 1/10 价计费的部分。
每天看一眼这行字,比月底看账单能早发现十倍的浪费。它也是后面所有优化的「对照组」——没有计量就没有优化。
2.2 一次提问的上下文结构:谁在缓存里,谁每轮都变
每次发给模型的消息分三段,缓存属性完全不同: