AI 不太需要脑子,需要靠谱:姚顺宇的四个小时与他的非共识判断
姚顺宇在访谈中判断,AI竞争重心已从“能不能做到”转向“有没有被良好定义”,SWE-bench 80%附近差距多为噪声。预训练远未到头,多数“撞墙”只是未发现的bug;Coding先爆发因反馈清晰、GitHub数据天然和审美共识。预训练与后训练本质都是强化学习,区别在数据分布。行业最稀缺的是靠谱而非聪明,个人英雄主义时代结束;壳公司要么逃得快,要么小到巨头看不上。读者可据此少追热点、先修bug、做有客观标准的事。

姚顺宇在访谈中判断,AI竞争重心已从“能不能做到”转向“有没有被良好定义”,SWE-bench 80%附近差距多为噪声。预训练远未到头,多数“撞墙”只是未发现的bug;Coding先爆发因反馈清晰、GitHub数据天然和审美共识。预训练与后训练本质都是强化学习,区别在数据分布。行业最稀缺的是靠谱而非聪明,个人英雄主义时代结束;壳公司要么逃得快,要么小到巨头看不上。读者可据此少追热点、先修bug、做有客观标准的事。
本文面向算力/Token销售入行者,指出其本质是依靠信息差、资源差、资金差的批发—分销生意,不生产算力或模型,而是把上游额度低价卖给下游。入行需掌握官转、中转站、号池、倍率等术语,并按五层天梯定位:第二层可稳定盈利,第三层合规天花板依赖政府算力、补贴与资金,灰黑渠道风险高。区域上西部近货源、东部近客户、成渝兼顾;产业链分上游芯片与模型、中游官方与中转分销、下游开发者与企业。读者可据此定位环节与合规路径。日均Token调用量超140万亿。
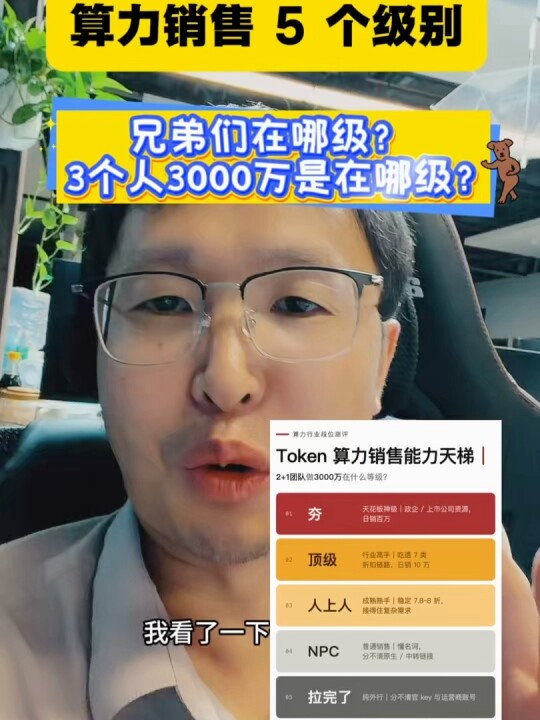
视频把卖算力/token按销售能力分五级段位,从认知未入门、NPC、行业高手到合规天花板,灰黑渠道另列。token分销链含官方、官转/官Q、中转站、自建账号及灰黑,折扣来自信息差、资源差、资金差。天梯实际考验链路理解、资源整合与合规承接资金风险的能力。高层单笔毛利率可能更低,但靠规模、返点和资源整合盈利;底层赚一次性信息差,易被比价打穿。灰黑玩家靠掺水、假冒、伪造返回拉高销量,却把法律、商业和信任风险拉满。结论是,真正值得攀登的是合规天梯。
AI趋势、模型格局、算力与开源资源是主线。KK提出未来十年八大AI趋势;dot云电脑让Agent用干净IP、少token焦虑,但勿授权主账号。小米MiMo V2.6开源低价,FreeToken使8G显存跑35B MoE。中国算力八大枢纽贡献全国八成以上智能算力,却上架率63%低于全国71.4%,约72万架未上电。字节、腾讯推AI网盘,竞争转向自动整理;上海交大、Raschka、xAI开源全链路教程、从零训练代码和Grok Build源码。核心结论:模型能力趋同,竞争转向算力布局、Agent驯服与开源复用,稀缺的是干净环境、工程方法和授权纪律。
文章实测验证可长期使用的免费大模型API,并澄清虚假免费信息。Agnes三款全模态API无限期免费,限每分钟20次;硅基流动部分9B以下模型永久免费,免费用户1000次/分钟;讯飞星辰MaaS有永久免费小模型及OCR、生图,并发100路;模力方舟有GLM-4.7-Flash等免费模型且不限并发,但需先充10元;智谱免费GLM-4.7-Flash等,限1并发但较稳。英伟达NIM、Ollama、上海AI实验室、魔搭、讯飞星火Lite也有免费额度。读者可据此避坑并按场景选择。
Jev是TypeSafe推出的早期访问决策模型,旨在将高频语义判断交给轻量决策模型,而非依赖通用基础软件。目前可通过三种途径获取:在typesafe.ai官网加入waitlist获取API key;使用Vercel AI Gateway(AI SDK 7)免排队,模型名填typesafe-ai/jev;或直接POST至api.typesafe.ai/v1/systemone(model填jev-latest)。官方提供Python(pip install typesafe-sdk)与JS/TS(npm install @typesafe-ai/sdk)SDK。其调用方式为传入state和业务问题,返回结构化决策与校准概率,而非生成文字,适合需要快速、可量化的业务判断场景。
SoL-Pi是NVIDIA研究团队构建的递归自改进(RSI)流水线,核心目标是提升编码代理框架的token效率。研究者让代理从公开数据和软件环境中构建可执行环境,在152个候选改进方向中通过自动研究循环筛选出4个有效机制:Action Fusion(合并编辑和运行命令)、Online Context Compact(子任务边界压缩)、ObservationPack(归档重复杂输出)、Evidence-Preserving Reducer(廉价代理验证日志摘要)。在EdgeBench基准上,SoL-Pi相对原生Codex和Claude Code框架节省35-64%的token消耗,成本降低50-54%,同时保留约94%的平均任务分数;对专业研究人员每小时可节省$8.75–$13.50。文章强调广度优先搜索能跳出局部最优,并展望了效率可递归改善的长期愿景。
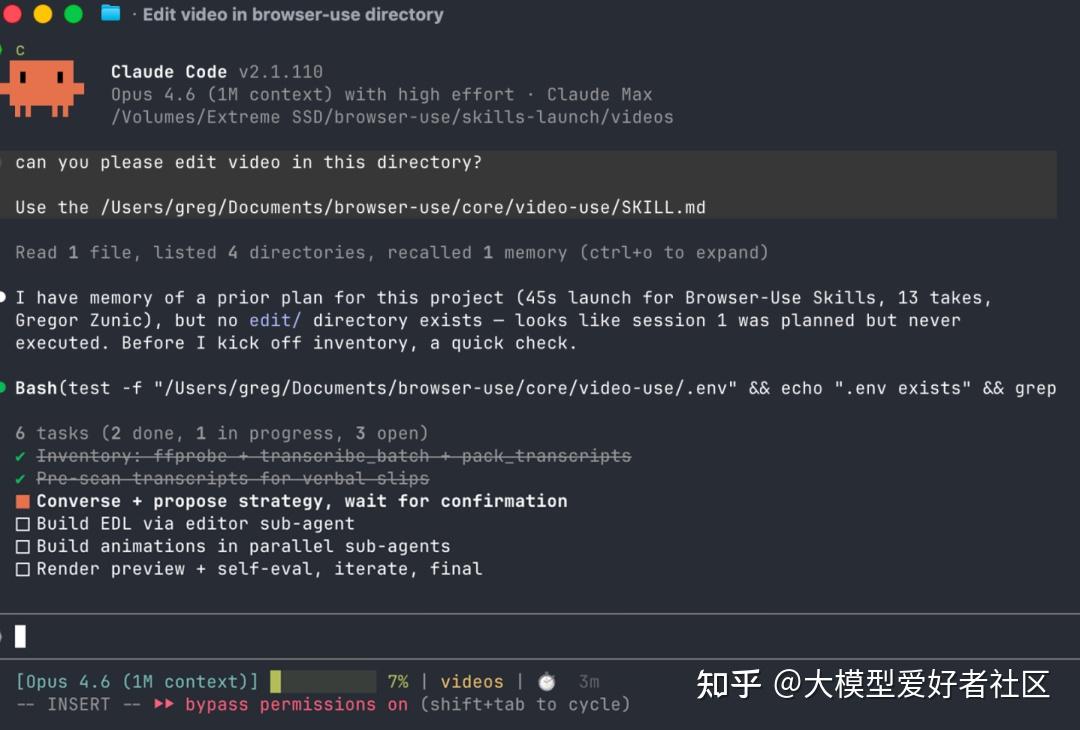
该文系统梳理AI领域核心术语的演进逻辑,指出这些概念并非凭空创造的黑话,而是为解决每一阶段工程痛点层层叠加的解决方案。内容按四层递进展开:基础交互层讲解LLM与Token的数学原理及Prompt工程方法论;记忆数据层介绍Context与Memory的上下文管理机制,以及RAG技术打通私有资料库、终结模型幻觉的效用;行动接口层说明Function Calling实现外部工具调用,MCP协议统一接口标准;自主工程化层阐述Agent融合感知、规划与工具调用的闭环系统,Skill作为可复用专家工作流,Harness构建防失控安全边界。最终揭示AI发展路径:从单纯陪聊进化为可独立执行复杂任务的自动化系统。
MCP(模型上下文协议)是Anthropic推出的标准化协议,通过为外部工具“套一层壳”统一Client与Server通信,解决大模型调用外部工具生态割裂问题。相比传统Function Calling需手写复杂API Schema、维护成本高且存在安全隐患,MCP借助官方SDK极大简化开发。其三层架构包括MCP Host/Client(如Claude桌面端、Cline插件)与MCP Server,通信基于JSON-RPC 2.0,支持stdio(本地场景)和HTTP+SSE(分布式场景)两种方式。值得注意的是,MCP规范仅约束Client与Server间通信,Client与大模型的对接灵活——实测Cline将工具说明以系统提示词拼接,单次消耗6万多字符,虽泛化性好、适配任意模型,但Token成本高。技术演进历经Prompt约定、Function Calling至MCP协议时代,走向即插即用的统一工具生态。
阿里千问27B稠密模型与DeepSeek开源工具壳DSH相继发布,使普通人仅凭两块RTX 5090显卡即可在本地运行性能超越早期GPT-4的AI,实现从按月租用云端算力到一次性硬件押金的转变。千问27B采用稠密架构,模型压缩至17G可完整装入32G显存,规避了混合专家模型不省显存的瓶颈;DSH框架则赋予本地模型读写文件等实操能力。此举不仅让用户获得议价权、抵御云端涨价断供,更推动机房推理效率提升十几倍,使AI单价趋近于零。依据杰文斯悖论,智力成本暴跌将激活大量长尾应用场景,AI从奢侈品变为基础设施。当“聪明”不再昂贵,唯一稀缺的是用户自身的目标与想法。